/2026年9月19日(土)掲載/
〈AI使用:記事はAnthropic Claude Sonnet?5を使用し、白楽が画像添付と校閲(加筆・訂正)をした。ただ、Claudeの記述に間違いがあり、白楽にも間違いがあり、訂正したが、まだ、間違いはある(多分)〉
目次(クリックすると内部リンク先に飛びます)
1.論文の内容
1-1.はじめに
1-2.Google Scholarへの依存度:教員調査の結果
1-3.異常な引用パターンの発見とc²指数の提案
1-4.大規模データにみる引用集中の広がりと実際のスキャンダル事例
1-5.実験1:プレプリントサーバーを悪用した引用の水増し
1-6.実験2:引用購入サービスによる引用の買収
1-7.学術誌内部に潜む引用カルテルの検出
1-8.結論と提言:引用数だけに頼らない評価へ
2.白楽の感想
1.論文の内容
1-1.はじめに
 本論文は、アラブ首長国連邦(United Arab Emirates)のニューヨーク大学アブダビ校(New York University Abu Dhabi、NYUAD)・コンピューターサイエンス学科のハゼム・イブラヒム(Hazem Ibrahim、写真出典)らによる実証研究である。
- 出典:Ibrahim H, Liu F, Zaki Y, Rahwan T. “Citation manipulation through citation mills and pre-print servers.”(邦訳:引用工場とプレプリントサーバーを通じた引用操作)
Scientific Reports. 2025;15:5480.
2025年2月14日付でオンライン公開
https://doi.org/10.1038/s41598-025-88709-7(オープンアクセス)
筆頭著者のイブラヒムは、アラブ首長国連邦のニューヨーク大学アブダビ校で理学士号を取得し、カナダのトロント大学(University of Toronto)で理学修士号を取得した、その後、米国のニューヨーク大学(New York University)・コンピューターサイエンス学科の博士院生になり、論文投稿時は最終学年だった。
2023年にイブラヒムは、MIT Technology Review誌の「35歳未満のイノベーター35人(35 Innovators Under 35)」に選ばれた(Hazem Ibrahim個人サイト)。
著者らの問題意識は次のとおりである。
論文の被引用数は、研究費(グラント)獲得やテニュア(終身在職権)審査をはじめとする科学者の業績評価に広く用いられている。そのため科学者には自らの被引用数を水増ししようとする誘因(インセンティブ)が働く。
著者らはGoogle Scholar上の約160万件の研究者プロフィールから成るデータセットを構築し、世界の有力大学の教員を対象に調査を行なって引用指標としてのGoogle Scholarの利用実態を確認した。
これまでの研究では、自らの過去の論文を過剰に引用する自己引用(self-citation)、複数の著者・学術誌が互いを引用し合うことで指標を押し上げる引用カルテル(citation cartel)、査読者や編集者が投稿者に自誌・自己の論文の引用を要求する強制引用(coercive citation)といった不正な引用慣行がすでに知られている。これらは総称して引用操作(citation manipulation)ないし参考文献リスト操作(reference list manipulation)と呼ばれてきた。
しかし、引用そのものを金銭で直接購入できるのかどうかは、これまで報告されていない。
この問いに答えるため、引用販売組織から実際に引用を購入できるか試し、50件の引用を300ドルで購入することに成功した。
本論文はその一部始終と、そこから得られた現代の学術評価システムの脆弱性を報告した。
1-2.Google Scholarへの依存度:教員調査の結果
著者らはまず、研究者評価の現場でGoogle Scholar(日本語版ウィキ:Google Scholar – Wikipedia)がどの程度用いられているかを確認するため、上位にランクされた10大学の教員3万人超に調査を依頼し、574件の回答を得た。
その結果、6割以上の回答者が、自分自身または他者の引用指標を確認する際にGoogle Scholarを情報源としていることがわかった。これは他のすべての情報源(Web of ScienceやScopusなど)を合計した利用率よりも高かった。
さらに回答者の73%は、自分の同僚たちも主にGoogle Scholarを参照していると考えていた。
この傾向はコンピューターサイエンス分野と社会科学分野で特に顕著だった。
Google Scholarは、多くの学術誌のように査読を経た論文だけでなく、プレプリント(査読前論文)や学位論文、会議録なども区別なく索引付けする点でWeb of ScienceやScopusとは性格が異なる。しかし、その簡便さゆえに研究者・大学・助成機関の実務において引用指標の事実上の標準になっている、と著者らは理解した。
1-3.異常な引用パターンの発見とc²指数の提案
著者らは、手作業で5名の「異常な」著者(以下の図の赤線)を特定し、通常の著者(以下の図の水色線)と比較する分析を行なった。
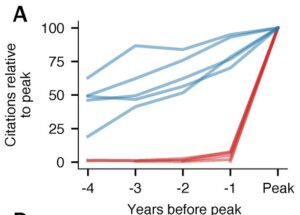 まず、各著者が最も多くの引用を受けた年と、それ以前の年間引用数を比較した(図A)。ここでは、著者間で比較しやすくするため、各著者の引用数のピーク時を100とした。図からわかるように、通常の著者たち(水色線)は、ピークに達する前に徐々に引用数が増加しているのに対し、異常な著者(赤線)たちは、ピーク年に急激に引用数が増加している。
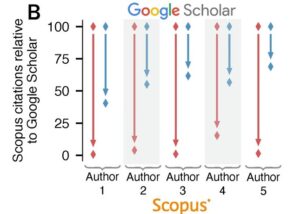 次に、Google ScholarとScopusにおける、各著者の最も引用数が多かった年の数値を比較した(図B)。Scopusは、独立したコンテンツ選定・諮問委員会が審査・選定した学術誌のみをインデックスしているため、引用数が減少するのは当然だが、異常な著者(赤線)の場合、Scopus での引用数は平均して96%も減少した。一方、通常の著者(水色線)の場合は43%の減少にとどまった。
上記の2点をまとめると、異常な著者は、特定の年に引用数が急増するが、そのうち96%以上の引用はScopus 上では見つからなかった。
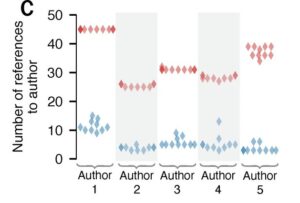 次に、各著者について最も多くの引用がある10 篇の論文に焦点を当てて分析した。図Cに示すように、異常な著者(赤線)は、1つの引用論文の中で最大 45 回も引用されていた。つまり、その著者の45 篇もの異なる論文が、その引用論文の参考文献として挙げられていた。一方、通常の著者(水色線)の場合、1つの引用論文の中での引用回数は15 回を超えることはなかった。
異常な著者は、ごく少数の論文から過度に多くの引用を受ける傾向がある。そこで、この異常な著者を特定する「引用集中指数(citation concentration index)」(略してc²指数(c²-index ))を提案する。
ある研究者の 引用集中指数(c²-index )とは、その研究者を少なくともn 回以上引用している論文がn 篇存在するという最大のnの値である。 引用集中指数(c²-index )がnの研究者については、その研究者が少なくともn 回以上引用されている論文から受けた引用の割合も計算する。
引用集中指数(c²-index )は、つまり、引用操作されたかどうかを断定できないが、操作された可能性のある引用の割合を把握することができる。
研究者の分布を把握するために、Google Scholarからランダムに100 人の研究者を抽出してを分析した。データセット内で著者数が最も多い9つの分野について、 引用集中指数(c²-index )および パーセンテージも計算した。この分析の結果を図 3Aに示す。
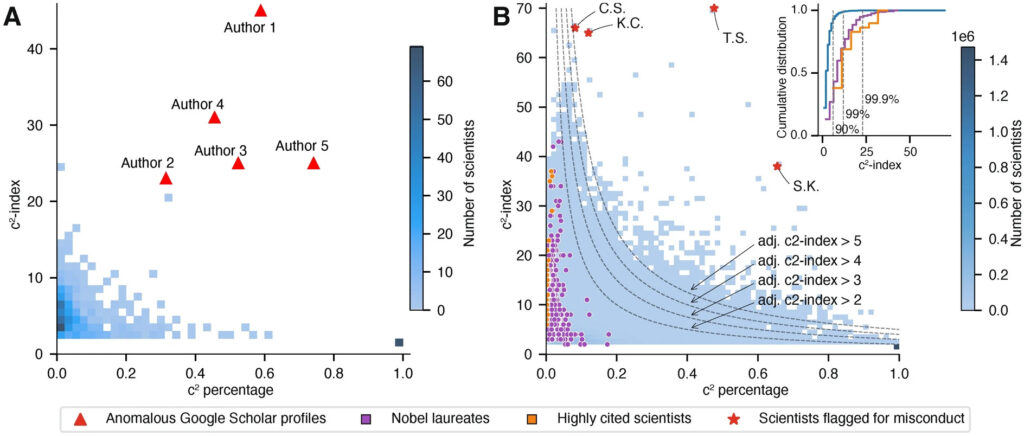
図 3Aに示した通り、大多数の科学者は分布の左下隅に位置した。これは、彼らがどの論文もおおむね1 回しか引用されていなかったからだ。 引用集中指数(c²-index )が10を超える科学者はごくわずかで、ランダムサンプル全体で最も高い 指数は25だった。
しかし、5人の異常な著者(赤▲)は、 引用集中指数(c²-index )の最低値は23で、最高値は45だった。つまり、この著者を45 回以上引用している論文が45 本もあったことになる。
この分析により、図に示されている5 人の異常な著者の特殊性が確認された。
〈白楽注:白楽はこの節の以下の内容を理解できていない〉
図 2Aで示されている異常な著者たちに関する情報の大部分は、ResearchGate のピアレビューを経ていない論文から得た。例えば、ある「異常な著者」の 引用集中指数(c²-index )に寄与している93 報の論文のうち、77 報はResearchGate 上に掲載されている。また、別の「異常な著者」の場合も、 引用集中指数(c²-index )に寄与している26 報の論文はすべてResearchGate 上に掲載されている。
これまで、Google Scholar 上のごく少数の著者についてのみ、 という 引用集中指数(c²-index )を調査した。これは、Google Scholarで引用情報を収集するのにコストがかかるためで、必要な情報を得るためには、その著者が受けている引用の総数に相当する回数のリクエストが必要になる。
そのため、この指標を大規模に適用するには、Microsoft 社の書誌情報データMicrosoft Academic Graph(MAG)を利用する必要がある。MAGには、1800 年以降に発表された2 億件以上の科学論文が含まれている。
1-4.大規模データにみる引用集中の広がりと実際のスキャンダル事例
〈白楽注:白楽はこの節の内容を理解できていない〉
著者らはさらに、マイクロソフト・アカデミック・グラフ(Microsoft Academic Graph、MAG)という大規模な学術文献データベースを用いて、引用集中指数(c²-index )の考え方をより広い母集団に適用した。
その際、単純なc²指数だけでは、共同研究者どうしが正当な理由で互いを繰り返し引用し合う場合(大規模な共同研究など)と、不正に引用を集中させている場合とを区別できないという課題があるため、著者らはc²指数に「集中した引用がその科学者の総被引用数に占める割合(c²比率)」を掛け合わせた「調整済みc²指数(adjusted c²-index)」も併せて算出した。
MAGデータベース全体では、調整済みc²指数が2以上の科学者が1万4441人、3以上が3525人、4以上が1161人、5以上が485人存在し、20を超える者も8人確認された。
比較のため、著者らはノーベル賞受賞者の調整済みc²指数も算出しており、いずれも2未満にとどまっていた。
図 3Bは、MAGのデータに基づき、少なくとも100 回以上引用されているすべての科学者の分布を、2つの指標、 引用集中指数(c²-index )と、 引用集中パーセンテージで示した。
図 3Bに示したように、この分布の形状は双曲線状である。一方で、大多数の科学者は、他の論文によって1 回しか引用されない。一方、優秀な科学者(つまり、ノーベル賞受賞者や多く引用される科学者)は、引用集中指数(c²-index )が高い傾向にありますが、 引用集中パーセンテージは低い。また、もし科学者が、しばしば一緒に引用されるような、影響力のある研究成果を多数発表していれば、引用集中指数(c²-index )が高くなることもある。
しかし、たとえこれらの非常に優秀な科学者であっても、彼らが受ける引用の総数は、全体の10%を超えることはほぼない(98.6パーセンタイル値)。20%を超えることもない。そのため、引用集中指数(c²-index ) が高くなることは稀になる(引用集中の99パーセンタイル値は12)。図 3Bの挿入部分に示したように、高い引用集中指数(c²-index )と高い 引用集中パーセンテージの両方を同時に持つことは、極めて稀である。
過去に研究不正の疑いで公に問題視された4名の科学者(論文中ではK.C.、T.S.、C.S.、S.K.という頭文字のみで匿名化されている)についても同じ指標を算出した。
すると、全員の調整済みc²指数が5を上回っていたことを報告している。著者らはこれらの人物の実名を伏せているが、極端な自己引用や大量の論文撤回(500本規模)などで過去に公になった事例が念頭に置かれているとみられる。
1-5.実験1:プレプリントサーバーを悪用した引用の水増し
次に著者らは、プレプリントサーバー(査読を経ていない論文を公開する場)がどの程度、引用の水増しに悪用され得るかを実証するため、架空の大学に所属する架空の研究者のGoogle Scholarプロフィールを作成した。この架空研究者の研究テーマを「Fake News(フェイクニュース)」とした。
そのうえで、対話型AI「ChatGPT」を用いて「フェイクニュース」を主題とする20本の論文を生成し、これをarXiv、Authorea、OSF(Open Science Framework)、ResearchGateという4つのプレプリントサーバーないし学術系ネットワーキングサイトに投稿しようと試みた。
結果は各サーバーの審査体制によって大きく異なった。
arXivは、投稿にあたって信頼できる研究機関のメールアドレスとの紐付け、または既存利用者による推薦(endorsement)を求めるため、投稿自体ができなかった。
AuthoreaとOSFは一定の事前審査(moderation)を経たうえで掲載を認めたが、ResearchGateは審査を一切行なわず即座に掲載を承認してくれた。
この架空の研究者のGoogle Scholarプロフィールは最終的に合計380件の被引用数、h指数19を記録し、「フェイクニュース」研究分野における被引用数ランキングで36位にランクインした。
なお、Authoreaは論文公開から2週間後にアカウントと関連論文をすべて削除したが、他のサーバーではそうした措置は取られなかった。
さらに著者らは、実在しない架空の参考文献を意図的に紛れ込ませたところ、その架空の文献までもがGoogle Scholarに索引付けされ、それを引用した論文の被引用数として計上されてしまうことも確認した。
この結果は、査読を経ない情報源を無差別に索引付けするGoogle Scholarは、引用操作の実質的な温床になっていることを示している。
1-6.実験2:引用購入サービスによる引用の買収
著者らはさらに踏み込み、インターネット上で見つけた、自称「H-index & Citations Booster」という引用販売を宣伝するオンラインサービスに、架空の研究者XYになりすまして接触した。
この組織は、300ドルで50件の引用、500ドルで100件の引用を、いずれも22誌の査読済み学術誌からの引用として、最大45日以内に納品すると謳っていた。著者らは実際に300ドルを支払って50件の引用パッケージを購入した。
その結果、5本の論文が架空研究者XYを共著者にいれた論文を引用する形で出版された。
そのうち4本は同一学術誌の同一の「特集号(special issue)」に掲載されたもので、購入からわずか33日後に出版されており、残る1本も40日後に出版された。
しかも、挿入された引用論文の約9割は本文中では一度も言及・議論されておらず、参考文献リストにのみ機械的に挿入されていたことが判明した。
さらに、この引用ネットワークを分析したところ、架空研究者XY以外の複数の実在の研究者も、同様に引用を購入したとみられることが確認できた。
1-7.学術誌内部に潜む引用カルテルの検出
著者らは最後に、実在するある学術誌(白楽注:論文では誌名を明かしていない)を対象に、2023年前半(1月から6月)に掲載された全論文を収集し、書誌結合(bibliographic coupling)という手法を用いて分析を行なった。
これは、2本の論文が少なくとも1件の同一の参考文献を共有している場合に両者を線で結ぶという手法で、タイプミスなどによる表記のゆれを拾うため、参考文献の文字列どうしのレーベンシュタイン距離(Levenshtein distance)に基づく類似度が0.98を超える場合も「同一」とみなして扱った。
この分析により、特定の著者への引用が不自然に集中する複数のクラスター(連結成分)が発見された。
たとえば、著者Aは、同誌に掲載された5本の異なる論文から、まったく同じ30本の自著論文への引用を繰り返し受けていた。
また著者Dは、8本の異なる論文から、同じ33本の自著論文への引用を繰り返し受けていた。
著者らはこうした分析から、5つのクラスターにまたがる11名の著者が、前述のような引用購入サービスを利用した疑いがあると結論づけている。
1-8.結論と提言:引用数だけに頼らない評価へ
著者らは、以上の一連の実験と分析から、Google Scholarには構造的に2つの問題があると総括した。
第一に、査読を経ていない情報源(プレプリントサーバーや、時には存在すらしない架空の文献)まで無差別に索引付けしていること。
第二に、ある研究者の被引用数がどのような情報源から積み上げられたものかが、利用者にはまったく見えない透明性の欠如である。
これを踏まえ、著者らは次のような対策を提言している。
第一に、書誌データベース各社は、単純な被引用数だけでなく、引用がどのように積み上がったかを追跡できる補助的な指標を報告すべきである。具体的には、先行研究がすでに提唱してきた自己引用の割合を示す自己引用指数(s-index)に加え、本論文が新たに提案したc²指数および調整済みc²指数を、異常な集中引用を検知する早期警戒の仕組みとして実装することが考えられる。
第二に、利用者が引用元の学術誌・媒体の質でフィルタリングできる機能を導入すべきである。
第三に、研究費配分機関やテニュア審査委員会など科学者を評価する側は、単純な被引用数の多寡だけで判断するのではなく、引用パターンの構造そのものを精査し、複数のデータベースを突き合わせて検証する姿勢が必要である。論文は末尾で、「本研究の知見は、引用操作の新たな形態を明るみに出すものであり、被引用数だけを見るのではなく、その先を見る必要性を強調するものである」と結んでいた。
なお著者らは、公開情報の収集・分析という手法そのものは米国憲法修正第1条によって保護される正当な調査行為であると位置づけたうえで、実験に関与した個人を特定し得る情報はすべて匿名化・削除したと付言している。
2.白楽の感想
《1》 引用の売買
引用数を直接お金で購入できる、つまり、引用工場(Citation Mill)があるのに驚いた。
そして、著者は実際に300ドルを支払って50件の引用数を購入した。
- Editverse Citation Booster Services
研究者のh-index向上に向けて、専門的な分析や出版戦略のサポートを提供するサービス。
- Scientific Publications (Google Scholar Citations Booster)
Google ScholarやScopusなどのデータベース上で、テクニカルな要件を満たしながら指標を向上させるための支援サービス。
《2》Google Scholarの構造的欠陥を実証した功績は大きいが、対策は「後追い」の域を出ない
架空の研究者を実際に作り、実在の引用販売組織に金を払って引用を買うところまで踏み込んで、Google Scholarの脆弱性を白日の下にさらした実証性は高く評価したい。
しかし提言の中身は、書誌データベース側に新指標の実装を「望む」、評価委員会に構造的な精査を「求める」という域を出ていない。Google社自身がGoogle Scholarの索引方針を変える経済的インセンティブを持たない以上、学術界からの要望だけで実効性のある改善が進むとは考えにくい。
研究資金配分機関や大学が、Google Scholarの指標を業績評価に用いること自体を制限するといった、より強制力のある対応策にまで踏み込んでほしかった。
《3》架空研究者による「なりすまし引用購入」実験の研究倫理上の位置づけが曖昧である
本論文は、実験の法的正当性について「公開データの収集は米国憲法修正第1条で保護される」と説明しているが、これは飽くまで「情報収集」の正当化であって、架空の身分を使って実在の商業サービスに金銭を支払い、AI生成の論文を実際にプレプリントサーバーへ公開し、実在の学術誌の特集号に不正な引用を実際に混入させたという、能動的な「介入型」実験の是非とは別の問題である。
この実験は結果として、無関係の第三者(架空の研究者と共に引用を「購入」されたとみられる実在の研究者たちや、不正な引用が紛れ込んだ特集号を発行した学術誌)にも影響を及ぼした可能性がある。論文中には所属機関の研究倫理委員会(IRB)の審査を経たという記載が見当たらず、この点の説明が不足していると言わざるを得ない。
《4》引用購入サービス名と対象学術誌を伏せたことの是非
著者らは、引用を購入した「H-index & Citations Booster」なるサービスの具体名も、引用カルテルを検出した学術誌の誌名も明らかにしていない。これは名誉毀損などの法的リスクを避けるための配慮とみられる。
しかし、結果として、どの業者・どの学術誌が実際に不正の温床になっていたのかを読者や研究公正当局が特定し、是正を求めることができない。
研究不正の告発と学術出版界への実効的な警告という観点からは、実名を伏せたことで告発の効果が大きく削がれている点は惜しまれる。
《5》日本の学術界への示唆:Google Scholar偏重の危うさ
日本の大学でも、教員個人の業績評価や科学研究費助成事業(科研費)の審査等において、h指数や被引用数を参照する際にGoogle Scholarの数字がそのまま用いられる場面は少なくない。
本論文が示した「回答者の6割超がGoogle Scholarを主たる情報源とする」という調査結果は、米国の有力大学に限った話ではなく、日本の大学人事や評価の現場にもそのまま当てはまる懸念がある。
日本の大学・学協会も、Google Scholarの数字を鵜呑みにせず、Web of ScienceやScopusとの照合、あるいは本論文が提案するc²指数のような構造的なチェックを、業績評価の実務に取り入れることを検討すべきだろう。
《6》c²指数には大型共同研究・学際研究者を誤って「異常」と判定するリスクがある
著者らは調整済みc²指数を導入することでこの問題にある程度配慮しているが、それでもなお、素粒子物理学や大規模ゲノム解析のような数百人規模の共同研究に参加する研究者、あるいは同じ共同研究チームどうしで正当に頻繁に引用し合う学際的な研究領域の研究者は、統計的には「異常な集中引用」に似たパターンを示しかねない。
c²指数やその調整版を実際の評価実務に組み込む際には、分野や研究形態の違いを踏まえた慎重な閾値設定と誤検知への対応策が不可欠であり、この点への目配りが本論文にはもう一段欲しいところである。
《7》プレプリントサーバー各社の審査体制の格差こそ、業界全体で是正すべき課題である
本論文が明らかにした、arXivは投稿自体を拒んだ一方でResearchGateは無審査で即時掲載したという結果の落差は象徴的である。
ResearchGateのように多くの研究者が日常的に利用する学術系ネットワーキングサイトが、実質的に無審査で論文もどきを公開し続ける限り、Google Scholarの索引方針だけを問題にしても片手落ちである。
プレプリントサーバーや学術系SNS事業者自身に対しても、最低限の内容審査や虚偽アカウントの検知体制を求める業界横断的な自主規制の枠組みが必要ではないか、というのが白楽の率直な感想である。